本地模型运行
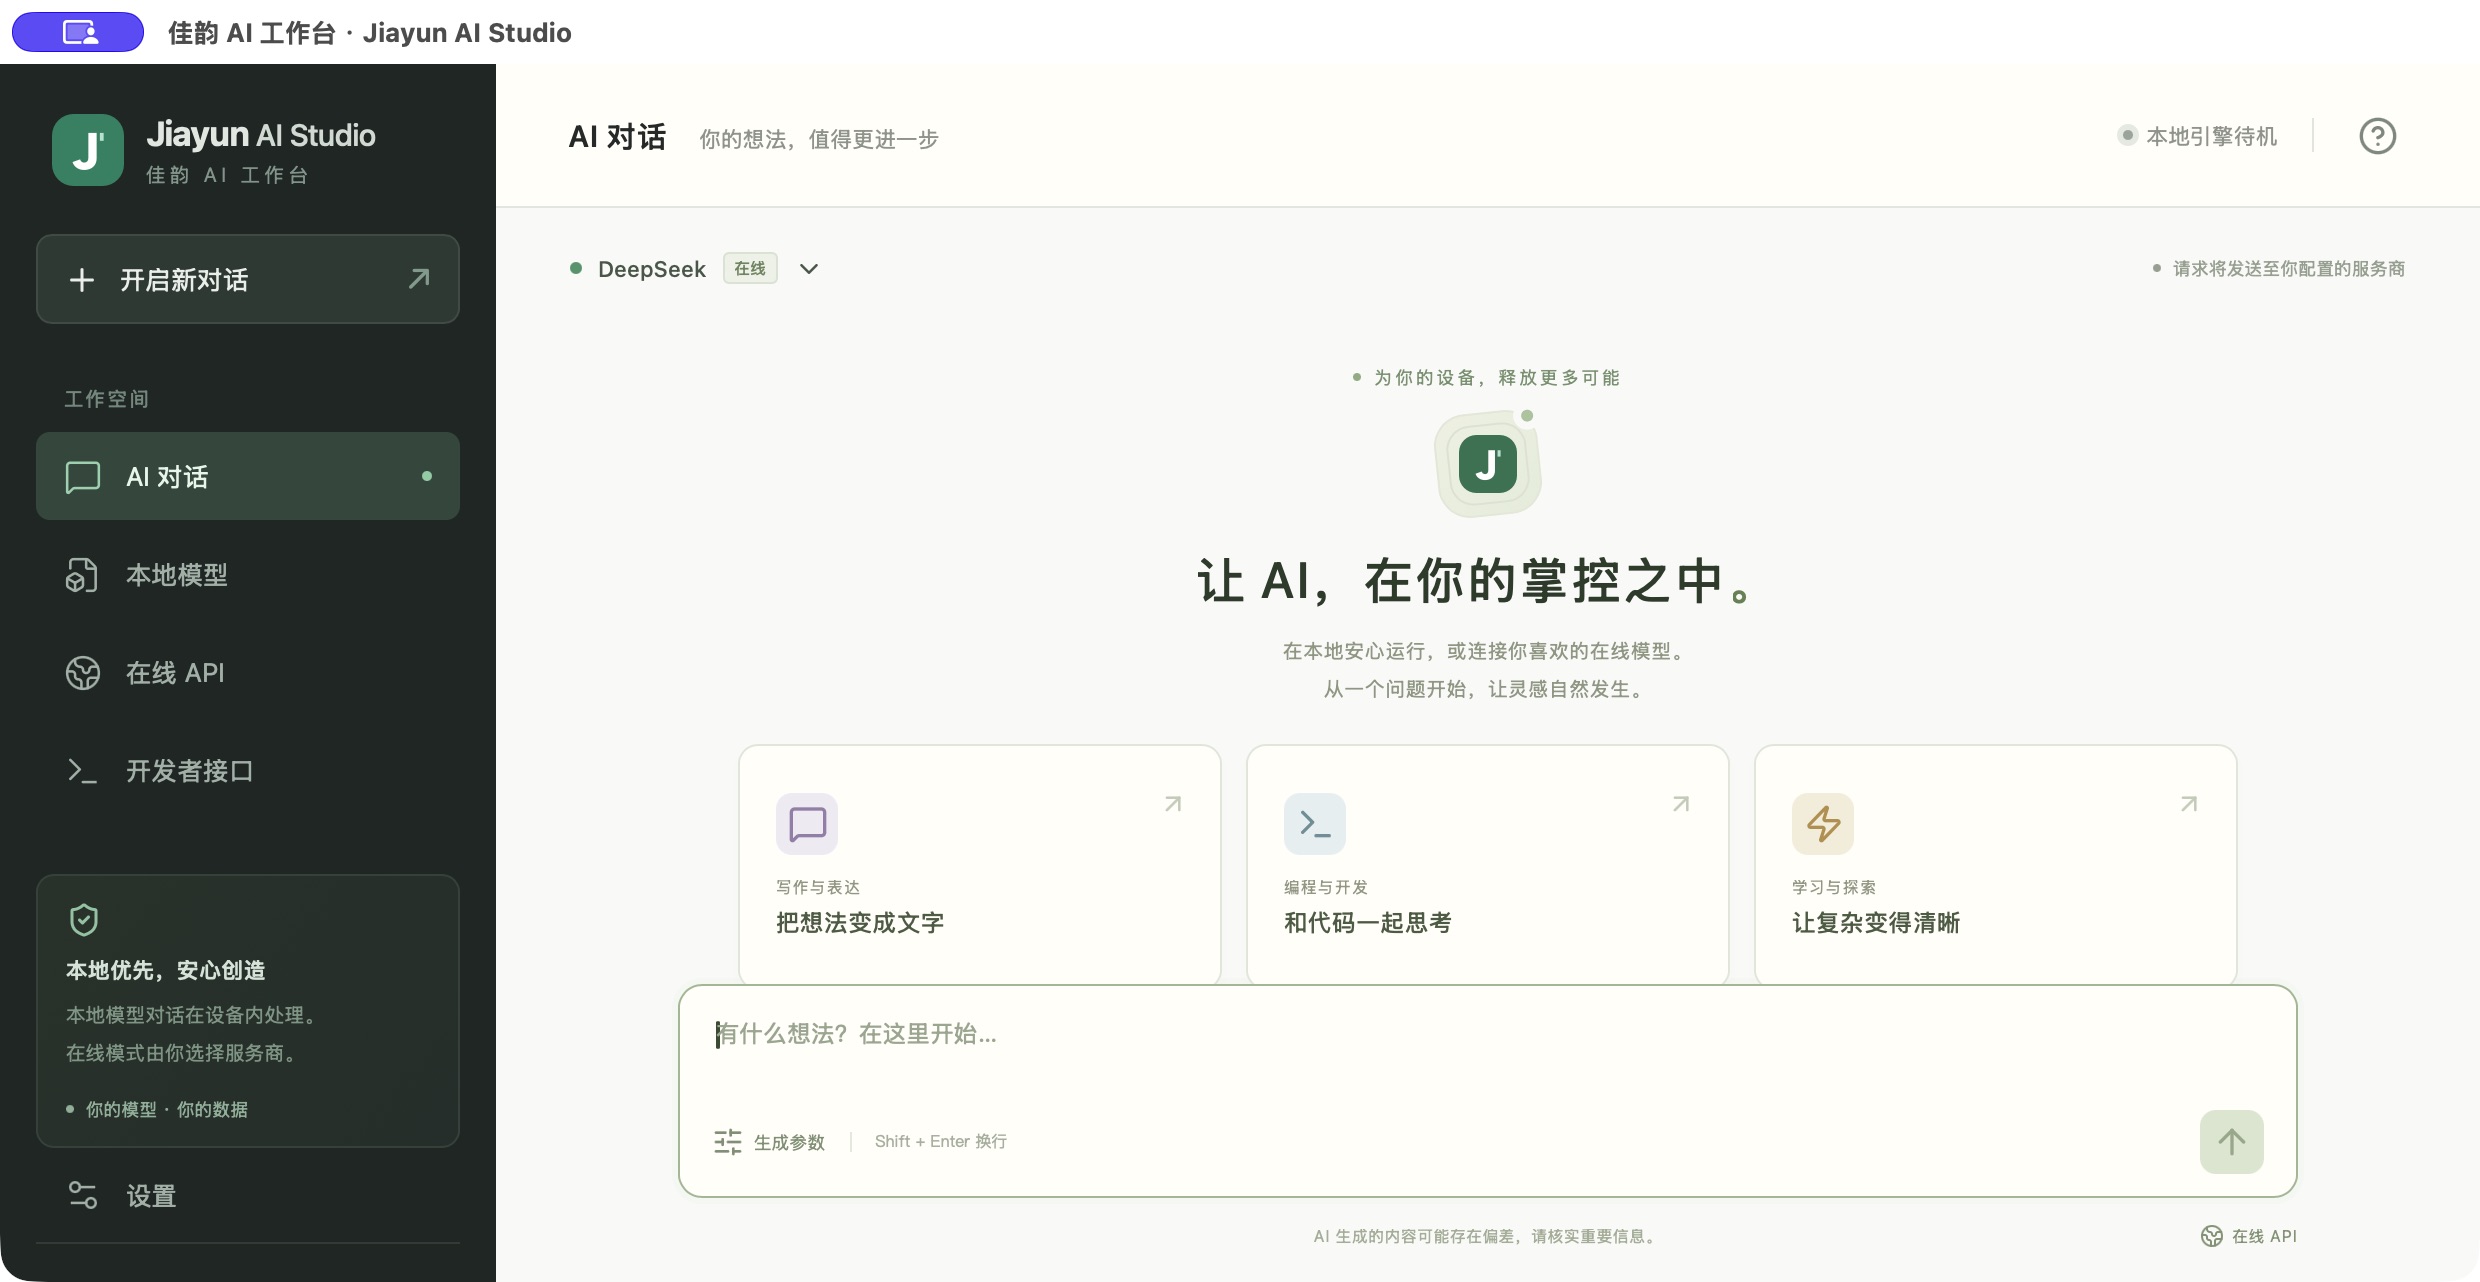
导入自己有权使用的 GGUF 模型,启动或停止推理进程,调整上下文长度、温度与 GPU 卸载层数。
A WORKSPACE FOR YOUR MODELS
无需另行安装 Ollama 或 Python。客户端、模型管理与本机推理引擎一起提供。
导入自己有权使用的 GGUF 模型,启动或停止推理进程,调整上下文长度、温度与 GPU 卸载层数。
配置兼容 OpenAI 接口格式的服务地址、模型 ID 与密钥。向在线服务发送前,界面说明接收方与数据范围。
可选启用带 Bearer 令牌的本机接口,仅监听回环地址,让自己的程序调用正在运行的本地模型。
LOCAL BY DESIGN
模型文件保存在你的设备上。本地模式由随应用附带的 llama.cpp 引擎处理对话;本地模型不可用时,不会自动将消息转发到在线服务。
了解本地数据处理BRING YOUR OWN API
用户自行准备服务账户和 API 密钥。在线模式直接向配置的 API 地址发送当前会话内容,不经过佳韵运营的 AI 中转服务。服务商可能另行收费,并按自身规则处理请求。
查看在线服务隐私说明